Inżynier danych: stos technologiczny, ścieżka kariery i wynagrodzenie
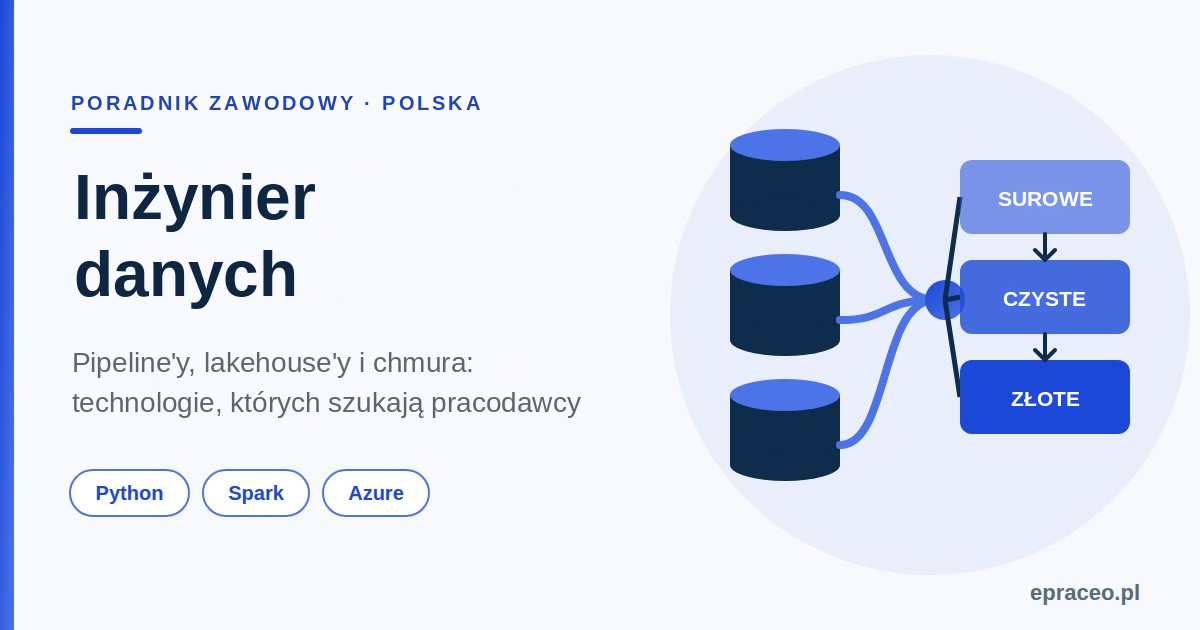
Inżynier danych (data engineer) tworzy i obsługuje potoki, które przenoszą dane z systemów źródłowych do hurtowni danych i jezior danych, gdzie mogą z nich korzystać analitycy, naukowcy zajmujący się danymi oraz modele sztucznej inteligencji. W Polsce rzadko jest to pierwsza praca w branży IT: większość inżynierów danych pochodzi z dziedzin takich jak analityka, programowanie backendowe lub bazy danych, a w ogłoszeniach o pracę dominuje platforma Azure z Databricks.
Co właściwie tworzy inżynier danych?
Każda firma posiada dane rozproszone w systemie ERP, CRM, sklepie internetowym, narzędziach marketingowych, arkuszach kalkulacyjnych i zewnętrznych interfejsach API. Inżynier danych łączy te źródła, kopiuje dane zgodnie z harmonogramem lub w trybie strumieniowym, oczyszcza je, łączy i przechowuje w strukturze, z której inni mogą pobierać dane bez konieczności zrozumienia, skąd pochodzi każde pole.
W aktualnych polskich ogłoszeniach o pracę oznacza to zazwyczaj architekturę typu „lakehouse”. Surowe dane trafiają do warstwy brązowej dokładnie w takiej postaci, w jakiej pochodzą ze źródła, warstwa srebrna zawiera oczyszczone i ustandaryzowane tabele, a warstwa złota zawiera modele gotowe do tworzenia raportów i uczenia maszynowego. Inżynier danych pisze skrypty transformacji między warstwami, zazwyczaj w językach SQL i PySpark, a narzędzie do koordynacji, takie jak Azure Data Factory lub Airflow, uruchamia je we właściwej kolejności.
Stworzenie potoku danych to dopiero połowa zadania. Druga połowa polega na zapewnieniu jego wiarygodności: testy jakości danych, które zatrzymują nieprawidłowy transfer, zanim dotrze on do pulpitu nawigacyjnego dyrektora finansowego, monitorowanie i alerty, dokumentacja pochodzenia każdej tabeli (pochodzenie danych), uprawnienia dostępu oraz koszty obliczeniowe, ponieważ nieostrożne zapytanie w dużym klastrze może znaleźć odzwierciedlenie w miesięcznym rachunku za chmurę.
Inżynier danych, analityk danych czy naukowiec zajmujący się danymi: kto czym się zajmuje?
Te trzy role pracują na tych samych danych, ale odpowiadają na różne pytania, a mylenie ich ze sobą jest częstą przyczyną rozczarowujących pierwszych doświadczeń zawodowych.
| Rola | Główne wyniki | Typowe narzędzia | Mierzone na podstawie |
|---|---|---|---|
| Inżynier danych | Potoki danych, modele danych, platforma danych | Python, SQL, Spark, Databricks, Data Factory, Airflow, dbt, Git | Niezawodność, aktualność i koszt danych |
| Analityk danych | Raporty, pulpity nawigacyjne, analizy na potrzeby decyzji biznesowych | SQL, Excel, Power BI, czasami Python | Przydatność wyników dla firmy |
| Naukowiec danych | Modele predykcyjne i statystyczne | Python, statystyka, biblioteki uczenia maszynowego | Jakość modeli i wpływ na biznes |
W mniejszych firmach jedna osoba może pełnić dwie z tych ról. W większych często pojawia się czwarta rola – inżynier analityczny – który zajmuje pozycję pośrednią między inżynierem danych a analitykiem i tworzy gotowe do wykorzystania w biznesie modele, często w dbt.
Klasyfikacja zawodów KZiS nie zawiera oddzielnej pozycji dla tego stanowiska. Najbliższe pozycje znajdują się w grupie 2521 – projektanci i administratorzy baz danych, na przykład 252103 projektant baz danych, więc zakres obowiązków określony w umowie lepiej opisuje tę rolę niż sam kod.
Jakich technologii oczekują polscy pracodawcy od inżyniera danych?
Python i SQL stanowią podstawę praktycznie każdego ogłoszenia. Oprócz nich stos technologiczny zależy od chmury wybranej przez pracodawcę:
- Azure: najczęstszą kombinacją jest Azure Databricks z PySpark, Azure Data Factory do koordynacji oraz Azure Data Lake do przechowywania danych, a w nowszych projektach pojawia się Microsoft Fabric.
- Specyfika Databricks: w ogłoszeniach o pracę dla osób z doświadczeniem wyraźnie wymieniane są Delta Lake, przepływy pracy i zadania, Delta Live Tables oraz Unity Catalog do zarządzania danymi.
- Snowflake i dbt: popularna para w firmach preferujących transformację opartą na SQL, często z wykorzystaniem Airflow do planowania zadań.
- AWS i GCP: S3, Glue i Redshift lub BigQuery w Google Cloud w firmach, które nie korzystają z rozwiązań Microsoftu.
- Przesyłanie strumieniowe: Kafka lub usługi zdarzeń w chmurze, gdzie dane muszą dotrzeć w ciągu kilku sekund, a nie z dnia na dzień.
- Praktyki inżynierskie: Git, CI/CD w Azure DevOps lub GitHub, zautomatyzowane testy oraz infrastruktura jako kod.
- Rozwiązania starszego typu: Microsoft SQL Server z SSIS nadal obsługuje wiele korporacyjnych hurtowni danych, a migracja do chmury jest powszechnym projektem.
W wielu ogłoszeniach pojawia się wymóg znajomości języka angielskiego na poziomie C1, ponieważ zespoły, klienci i dokumentacja mają charakter międzynarodowy. Niektóre ogłoszenia wymieniają również konkretne certyfikaty Databricks lub Azure jako atut.
Jak ludzie zaczynają karierę w inżynierii danych?
Ogłoszenia o pracę dla juniorów w tej dziedzinie są rzadkością, a te, które się pojawiają, przyciągają ogromną liczbę kandydatów. Większość osób przechodzi z pokrewnych stanowisk, na których już zawodowo zajmowali się danymi. Najczęstszym źródłem są analitycy: analityk danych lub programista BI, który biegle posługuje się językiem SQL, zaczyna tworzyć procesy ETL i stopniowo przejmuje odpowiedzialność za potoki danych. Drugim źródłem jest programowanie backendowe, gdzie kandydaci wnoszą znajomość Pythona lub Scali oraz dobre nawyki programistyczne. Trzecim są bazy danych: administratorzy i programiści ETL znający SQL Server i SSIS, którzy przechodzą przekwalifikowanie w kierunku chmury.
Absolwenci kierunków informatyki, matematyki stosowanej lub automatyki i robotyki mogą rozpocząć karierę w ramach programów dla absolwentów i akademii prowadzonych przez firmy konsultingowe i outsourcingowe, które szkolą grupy uczestników w zakresie konkretnego stosu technologicznego i kierują ich do pracy nad projektami klientów. Niezależnie od wybranej ścieżki pomocny jest projekt do portfolio: kompletny potok danych, który pobiera dane z publicznego API, przechowuje je w chmurowym jeziorze danych, przekształca je warstwowo, testuje i udostępnia na prostym pulpicie nawigacyjnym. Opisz go w swoim CV tak, jak opisałbyś system produkcyjny.
Wielu inżynierów danych pracuje dla firm konsultingowych i outsourcingowych, a nie bezpośrednio dla przedsiębiorstwa będącego właścicielem danych. Model ten pozwala w ciągu kilku lat zdobyć doświadczenie w różnych branżach i stosach technologicznych, co przyspiesza naukę, ale oznacza również zmianę projektów, klientów, a czasem nawet stref czasowych. Firmy produktowe i banki oferują głębszą znajomość jednej platformy w zamian za mniejszą różnorodność.
Które certyfikaty warto posiadać?
Certyfikaty nie zastępują doświadczenia projektowego, ale pomagają w dwóch sytuacjach: gdy zmieniasz stosy technologiczne i potrzebujesz dowodu, że znasz nowy, oraz gdy pracujesz dla firmy konsultingowej, której status partnerski z dostawcą zależy od certyfikowanego personelu. Najbardziej istotne dla polskich ogłoszeń o pracę są:
- Microsoft Certified: Fabric Data Engineer Associate (egzamin DP-700), aktualny certyfikat Microsoftu w zakresie inżynierii danych,
- Certyfikowany inżynier danych Databricks na poziomie Associate i Professional,
- Certyfikowany inżynier danych AWS na poziomie Associate,
- Profesjonalny inżynier danych Google Cloud,
- SnowPro Core dla środowisk Snowflake.
Jak wygląda codzienna praca inżyniera danych?
Dobry dzień przypomina tworzenie oprogramowania: wybierasz zgłoszenie, piszesz transformację, dodajesz testy, otwierasz pull request i sprawdzasz kod kolegi. Spotkania z właścicielami systemów źródłowych zajmują więcej czasu, niż osoby z zewnątrz się spodziewają, ponieważ stabilność potoku zależy od porozumienia co do tego, co i kiedy wysyła źródło.
Zły dzień zaczyna się od nieudanego nocnego ładowania danych. System źródłowy zmienił nazwę kolumny, plik dotarł z opóźnieniem lub klasterowi zabrakło pamięci, a poranne raporty dla zarządu są puste. Wiele zespołów stosuje system dyżurów, a inżynier danych pełniący dyżur musi znaleźć przyczynę, naprawić ją i ponownie załadować brakujące dane bez tworzenia duplikatów. Projektowanie potoków, które można bezpiecznie uruchomić ponownie, jest jedną z umiejętności odróżniających seniorów od juniorów.
Dane osobowe wiążą się z dodatkowymi wymogami prawnymi. Zgodnie z RODO (polskiej nazwy RODO) dane klientów muszą być ograniczone do niezbędnego minimum, chronione i usuwane w odpowiednim terminie, a w bankach ustawa DORA nakłada dodatkowe wymagania dotyczące odporności i postępowania w przypadku incydentów w systemach informatycznych. Dlatego inżynierowie danych coraz częściej współpracują z specjalistami ds. bezpieczeństwa i specjalistami ds. zgodności w zakresie maskowania danych, praw dostępu i zasad przechowywania danych.
Ile zarabia inżynier danych – w modelu B2B czy na podstawie umowy o pracę?
Inżynieria danych to jedna z lepiej opłacanych specjalizacji w polskiej branży IT. Nawet inżynierowie danych na średnim szczeblu zarabiają wyraźnie powyżej średniej krajowej, a specjaliści z doświadczeniem w zakresie Sparka i architektury chmurowej – znacznie powyżej tej średniej. Rzadko spotykane stanowiska dla juniorów zazwyczaj również oferują wynagrodzenie powyżej średniej krajowej, ponieważ pracodawcy oczekują od nich solidnej znajomości języka SQL i programowania już od pierwszego dnia pracy.
Umowy B2B są bardzo powszechne, zwłaszcza w firmach outsourcingowych i konsultingowych, które kierują inżynierów do projektów dla zagranicznych klientów, a ogłoszenia często podają stawki godzinowe w ramach umów B2B obok miesięcznych wynagrodzeń wynikających z umowy o pracę. Trudno jest bezpośrednio porównać te dwie opcje, biorąc pod uwagę składki na ZUS, podatki, płatny urlop i zwolnienia lekarskie, dlatego warto sprawdzić obie oferty za pomocą kalkulatora wynagrodzeń. Inne czynniki wpływające na wysokość wynagrodzenia to: poziom doświadczenia w pracy ze Sparkiem i chmurą, znajomość języka angielskiego, dodatki za dyżury oraz to, czy pracujesz w firmie produktowej, banku czy w firmie konsultingowej.
Jak wygląda rekrutacja na stanowisko inżyniera danych?
Wstępna selekcja CV skupia się głównie na stosie technologicznym i rodzaju projektów, więc należy wymienić narzędzia oraz skalę: ile źródeł, jaka ilość danych, przetwarzanie wsadowe czy strumieniowe. Rozmowy techniczne zazwyczaj obejmują SQL z funkcjami okienkowymi i deduplikacją, kodowanie w Pythonie oraz pytania dotyczące wewnętrznych mechanizmów Sparka, takich jak partycjonowanie, przetasowywanie i asymetria danych.
Kandydaci na stanowiska wyższego szczebla otrzymują zadanie projektowe: mają narysować schemat przetwarzania danych dla danego przypadku biznesowego, wybrać przetwarzanie wsadowe lub strumieniowe, wyjaśnić, w jaki sposób poradziliby sobie z opóźnionymi danymi, uzupełnianiem danych historycznych i powoli zmieniającymi się wymiarami, a także opisać, jak przetestowaliby i monitorowali takie rozwiązanie. Rozmowy kwalifikacyjne często odbywają się częściowo lub w całości w języku angielskim. CV na stanowiska IT, w którym wymieniono konkretne migracje lub platformy, które kandydat stworzył, prezentuje się lepiej niż długa lista technologii.
Jak sztuczna inteligencja zmienia popyt na inżynierów danych?
Każdy projekt z zakresu sztucznej inteligencji opiera się na czystych, udokumentowanych i dostępnych danych, co sprawia, że popyt na inżynierów danych pozostaje wysoki, nawet gdy tempo rekrutacji w innych obszarach IT uległo spowolnieniu. Firmy, które chcą wykorzystywać modele językowe do analizy własnych dokumentów i rejestrów, potrzebują przede wszystkim osób, które zbudują niezawodne potoki danych, katalogi i mechanizmy kontroli dostępu.
Jednocześnie asystenci programistyczni oparci na sztucznej inteligencji piszą większość standardowego kodu: proste transformacje, łączniki, testy i dokumentację. Zadania pozostające w gestii ludzi to architektura, kompromisy między kosztami a aktualnością danych, modelowanie danych, zarządzanie danymi oraz usuwanie awarii, których nikt nie przewidział. Największa presja występuje na poziomie stanowisk dla początkujących, co jest kolejnym powodem, dla którego większość osób nadal wkracza w tę branżę z pokrewnych stanowisk.
Często zadawane pytania dotyczące inżynierów danych
Czy inżynieria danych to dobra pierwsza praca w branży IT?
Jest to możliwe, ale trudne. Stanowiska młodszych inżynierów danych są rzadkie i bardzo konkurencyjne, ponieważ praca ta wymaga jednocześnie umiejętności programowania, znajomości języka SQL, wiedzy o chmurze oraz dyscypliny w środowisku produkcyjnym. Bardziej typową ścieżką kariery jest rozpoczęcie pracy jako analityk danych, programista BI, programista backendowy lub specjalista ds. baz danych, a następnie przejście do inżynierii danych po zdobyciu doświadczenia w pracy z rzeczywistymi danymi.
Czy inżynierowie danych muszą znać Javę lub Scalę?
Zazwyczaj nie. Python z PySparkiem i SQL pokrywają większość polskich ogłoszeń o pracę. Scala pojawia się w niektórych projektach intensywnie wykorzystujących Spark i strumieniowanie danych, a Java – w firmach korzystających ze starszych systemów Hadoop lub Kafka. Lepszą inwestycją jest najpierw gruntowne opanowanie Pythona i SQL, a Scalę można dodać później, jeśli wymaga tego konkretny projekt.
Jaka jest różnica między ETL a ELT?
W modelu ETL dane są ekstrahowane, przekształcane poza systemem docelowym, a następnie ładowane. W modelu ELT surowe dane są najpierw ładowane, a następnie przekształcane wewnątrz hurtowni danych lub lakehouse’u z wykorzystaniem ich mocy obliczeniowej. Platformy chmurowe, takie jak Databricks i Snowflake, sprawiły, że ELT stało się dominującym podejściem, ale wiele systemów korporacyjnych nadal korzysta z klasycznych procesów ETL.
Czy inżynierowie danych pracują na dyżurach?
Często tak. Gdy nocne ładowanie danych zasila poranne raporty lub systemy obsługujące klientów, ktoś musi reagować na awarie poza godzinami pracy. Wiele zespołów stosuje system dyżurów z dodatkowym wynagrodzeniem. Zapytaj o zasady dotyczące dyżurów podczas rekrutacji, ponieważ różnią się one znacznie w zależności od firmy i mają wpływ zarówno na wynagrodzenie, jak i na równowagę między życiem zawodowym a prywatnym.
Którą platformę chmurową powinien najpierw opanować inżynier danych?
Azure, ponieważ pojawia się w największej liczbie polskich ogłoszeń dotyczących inżynierii danych, najczęściej w połączeniu z Databricks i Data Factory. AWS i Google Cloud są powszechnie stosowane w firmach technologicznych i produktowych. Podstawowe pojęcia, takie jak przechowywanie danych, moc obliczeniowa, koordynacja i bezpieczeństwo, mają charakter uniwersalny i są wspólne dla różnych chmur, więc wybór pierwszej platformy ma mniejsze znaczenie niż jej gruntowne opanowanie.
„,
„occupationalCategory”: „Grupa KZiS 2521 Projektanci i administratorzy baz danych, pozycje najbardziej zbliżone”
}